 Skip to main content
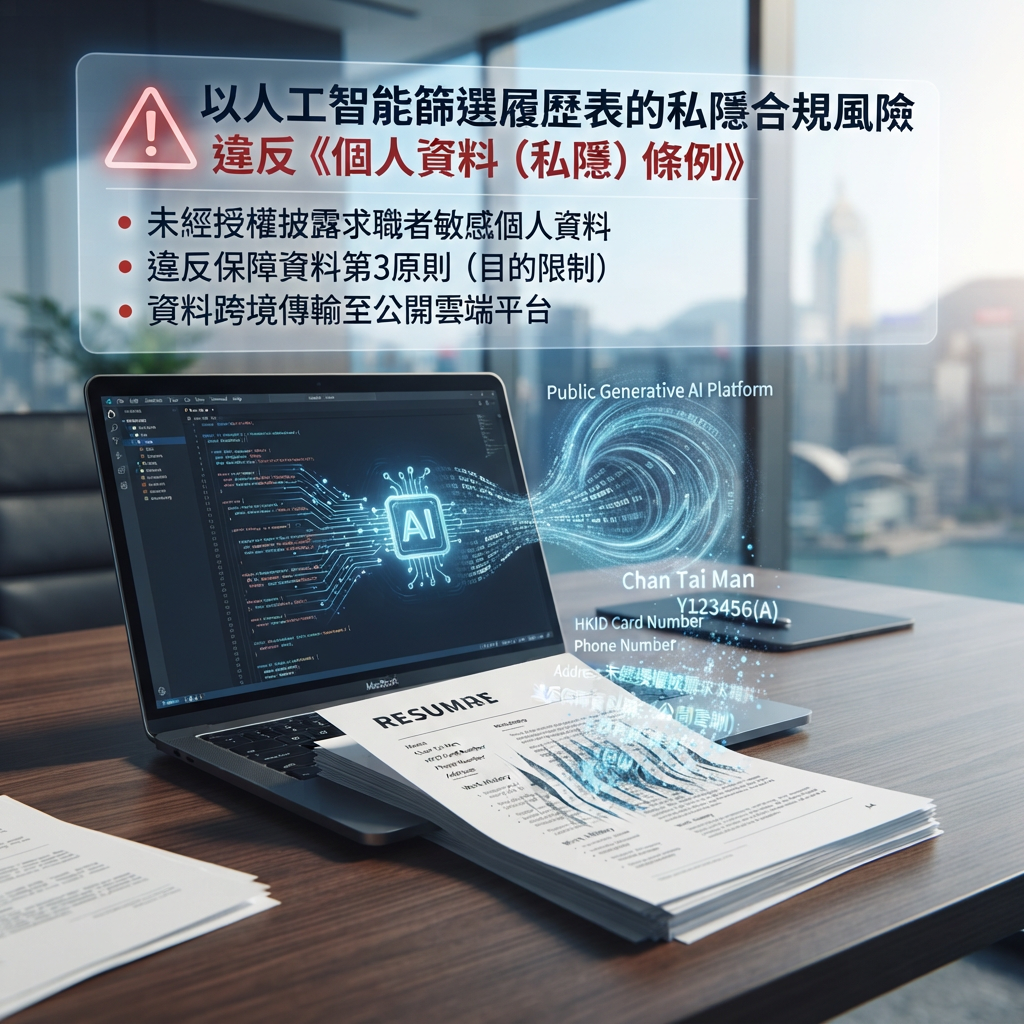 香港中小型企業在刊登招聘廣告後,常於短時間內接獲大量求職信與履歷表。部分管理人員為提升篩選效率,選擇將候選人的履歷表內容複製至公開生成式人工智能平台進行摘要分析與職位匹配評估。然而,此類行政操作使企業暴露於法律合規風險之中,並可能違反香港法例第486章《個人資料(私隱)條例》的相關規定。
公開大型語言模型的數據處理機制與目的限制
通用生成式人工智能服務在預設架構下,會將使用者輸入的文字、檔案及指令納入模型數據庫,用作演算法持續訓練與優化。求職者履歷表包含姓名、身份證號碼、住址、聯絡電話、過往薪酬及學歷等高度敏感的個人資料。將該等資料輸入公開平台,實質上構成資料外洩的潛在路徑。根據香港《個人資料(私隱)條例》保障資料第3原則,資料使用者在未取得資料當事人明確同意前,不得將個人資料用於收集時所述目的以外的新目的。求職者遞交履歷表之目的僅限於應徵指定職位,並未授權機構將其資料轉移予第三方公有雲端平台作商業模型訓練,未經授權變更資料用途將面臨個人資料私隱專員公署的投訴與調查。
跨境傳輸與神經網絡黑盒架構之合規限制
處理履歷表涉及保障資料第4原則,即資料使用者須採取切實可行步驟,保障個人資料免受未獲授權的查閱、處理、刪除或喪失。通用人工智能服務商的伺服器大多設於美國或歐洲,上傳資料涉及跨境數據傳輸。歐洲數據保護委員會針對大型語言模型的調查指出,生成式人工智能具備黑盒架構特性,當個人資料被模型吸收並轉化為神經網絡中的權重參數後,技術上難以執行精確刪除或行使被遺忘權。當未獲聘用的候選人依據法例要求銷毀其應徵資料時,機構無法自公有模型中徹底清除相關紀錄,使企業在法規審計時承擔違規責任。
演算法歷史偏差與僱主轉承歧視責任
部分機構試圖透過人工智能工具排除人為篩選偏見,但學術研究顯示,依賴通用大型語言模型進行求職者初篩容易放大既有刻板印象。哈佛商學院與麻省理工學院的聯合研究顯示,模型傾向偏好男性主導的傳統詞彙,或對因家庭照顧而具就業空窗期的女性候選人給予較低評價。公開模型的訓練資料源自歷史網絡資訊,會複製並放大歷史數據的瑕疵。香港僱傭範疇受《性別歧視條例》、《殘疾歧視條例》、《家庭崗位歧視條例》及《種族歧視條例》規管。若企業採用的工具邏輯涉及對特定群體的隱性歧視,僱主依法仍須承擔轉承責任,無法以技術決定作為抗辯理由。
資料去識別化與專用雲端系統之應用標準
企業若需提升履歷篩選效率並符合法規要求,可行方案包括嚴格執行資料去識別化程序,在分析前遮蔽姓名、電話、電郵、學校及住址等識別資訊,僅保留客觀技能與工作經歷。另一合規方案為採用符合數據私隱標準的專用雲端人力資源管理系統。具備明確數據邊界的專用系統承諾不將企業輸入的資料用於公共模型訓練,並透過數據加密與本地法規指引,在受控環境內執行人才管理,兼顧行政效率與個人資料保護要求。

